Прототип, 2017
11 GPU з рідинним охолодженням в одному корпусі
Двопроцесорна серверна платформа в одному корпусі, спроєктованому в CAD, з одним рідинним контуром.
GRUENCY / Робочі станції для AI
Навчання моделей і локальний інференс LLM тримають машину на повній потужності годинами або днями. GRUENCY підбирає GPU, живлення та охолодження під таке безперервне навантаження. Кожна робоча станція для AI проходить стрес-тест перед постачанням.
Обчислювальна потужність, пам'ять, лінії PCIe, живлення та шум визначаються разом, виходячи з моделей, які ви запускаєте.
Кожна робоча станція для AI залишає Варшаву з власним протоколом випробувань. Він містить тривалий стрес-тест під повним навантаженням, тепловий профіль кожного GPU та перевірку шуму щодо узгодженого рівня. Після доставки Sebastian дистанційно вводить машину в експлуатацію у вашому середовищі. Вимірюється також швидкість: продуктивність GPU і пам'яті та кількість токенів за секунду на мовних моделях.
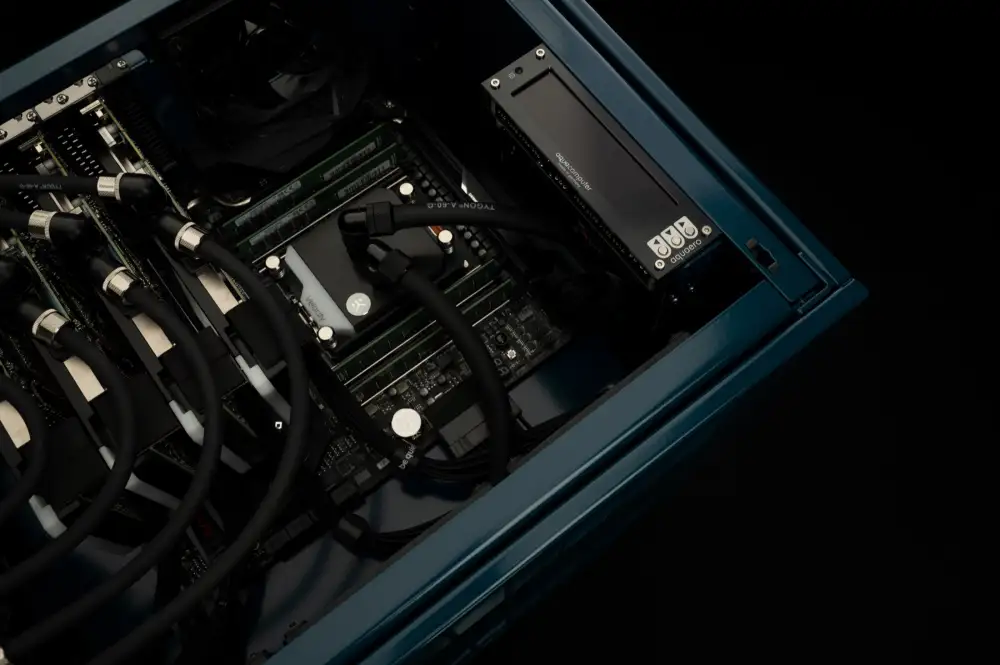
Двопроцесорна серверна платформа в одному корпусі, спроєктованому в CAD, з одним рідинним контуром.
Роботи для NVIDIA у сфері систем AI, рендерингу та візуалізації. Клієнти WS.COMPUTER працюють у понад 30 країнах.
Машини кількох поколінь GPU, кожна підібрана під свої задачі.
Виходячи з моделей, які ви запускаєте. Кількість параметрів, квантизація, довжина контексту та розмір батча визначають потрібний обсяг VRAM і пропускну здатність пам'яті. Це перше питання консультації.
Це залежить від тривалого енергоспоживання та цільового рівня шуму. Два GPU часто можна охолоджувати повітрям. Чотири й більше GPU під безперервним навантаженням зазвичай потребують індивідуального рідинного контуру.
Так. Машини постачаються по всьому ЄС і світу в транспортному пакуванні, виготовленому під них. Дистанційне введення в експлуатацію у вашому середовищі входить у кожне постачання.
Опишіть моделі, дані та місце, де працюватиме машина.
Або напишіть на info@gruency.com · Конфігуруйте на WS.COMPUTER