Prototip, 2017
11 GPU-uri răcite cu lichid într-o singură carcasă
O platformă server dual-CPU într-o singură carcasă proiectată în CAD, răcită de un singur circuit de lichid.
GRUENCY / Stații de lucru AI
Antrenarea modelelor și inferența LLM locală țin o mașină la putere maximă ore sau zile întregi. GRUENCY dimensionează GPU-urile, alimentarea și răcirea pentru această sarcină continuă. Fiecare stație de lucru AI este testată prin burn-in înainte de livrare.
Puterea de calcul, memoria, liniile PCIe, alimentarea și zgomotul sunt specificate împreună, pornind de la modelele pe care le rulați.
Fiecare stație de lucru AI pleacă din Varșovia cu propriul raport de testare. Acesta include un burn-in susținut la sarcină maximă, un profil termic pentru fiecare GPU și o verificare a zgomotului față de ținta convenită. La sosire, Sebastian pune mașina în funcțiune de la distanță în mediul dumneavoastră. Se măsoară și viteza: performanța GPU și a memoriei, precum și tokenii pe secundă pentru modele lingvistice.
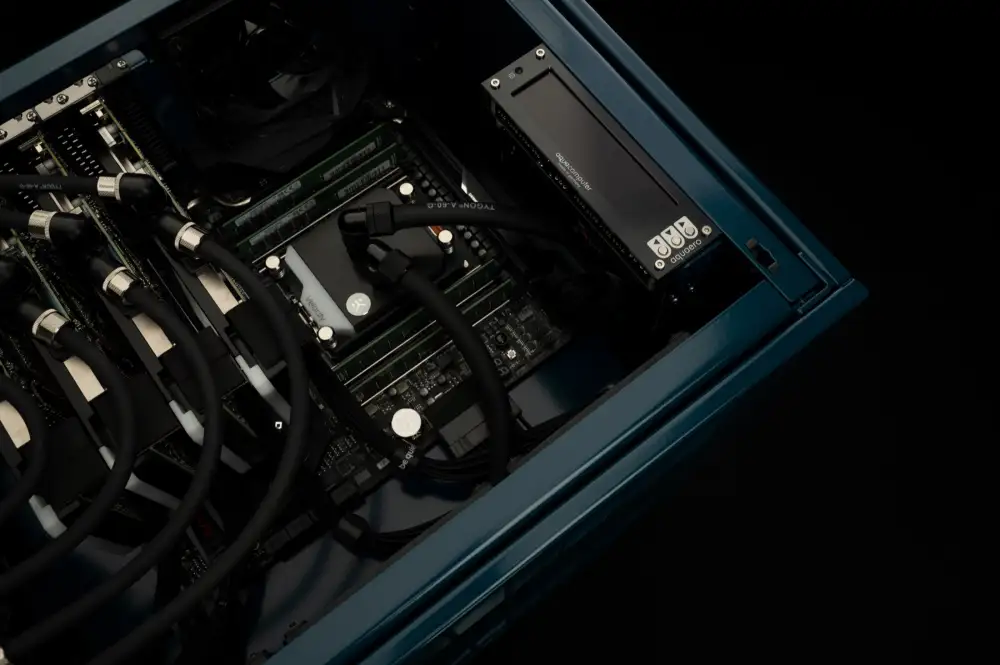
O platformă server dual-CPU într-o singură carcasă proiectată în CAD, răcită de un singur circuit de lichid.
Lucrări ca furnizor pentru NVIDIA în domeniul sistemelor AI, de randare și de vizualizare. Clienții WS.COMPUTER provin din peste 30 de țări.
Mașini din generații succesive de GPU-uri, fiecare specificată pentru sarcina sa de lucru.
Pornind de la modelele pe care le rulați. Numărul de parametri, cuantizarea, lungimea contextului și dimensiunea lotului determină VRAM-ul și lățimea de bandă a memoriei necesare. Aceasta este prima întrebare din consultație.
Depinde de consumul susținut și de ținta de zgomot. Două GPU-uri pot fi adesea răcite cu aer. Patru sau mai multe GPU-uri sub sarcină continuă necesită de obicei un circuit de răcire cu lichid personalizat.
Da. Mașinile sunt livrate în toată UE și în întreaga lume, în ambalaje de transport personalizate. Punerea în funcțiune de la distanță în mediul dumneavoastră face parte din fiecare livrare.
Descrieți modelele, datele și locul în care va fi folosită mașina.
Sau prin e-mail info@gruency.com · Configurați pe WS.COMPUTER