Protótipo, 2017
11 GPUs com refrigeração líquida num só chassis
Uma plataforma de servidor com dois CPUs num único chassis projetado em CAD, arrefecida por um só circuito de refrigeração líquida.
GRUENCY / Estações de trabalho de IA
O treino de modelos e a inferência local de LLM mantêm uma máquina à potência máxima durante horas ou dias. A GRUENCY dimensiona as GPUs, a alimentação e a refrigeração para essa carga contínua. Cada estação de trabalho de IA é testada em burn-in antes da entrega.
Computação, memória, linhas PCIe, alimentação e ruído são especificados em conjunto, a partir dos modelos que utiliza.
Cada estação de trabalho de IA sai de Varsóvia com o seu próprio registo de testes. Este inclui um burn-in contínuo à carga máxima, um perfil térmico de cada GPU e uma verificação do ruído face ao objetivo acordado. À chegada, Sebastian coloca a máquina em funcionamento remotamente no seu ambiente. A velocidade também é medida: desempenho da GPU e da memória, e tokens por segundo em modelos de linguagem.
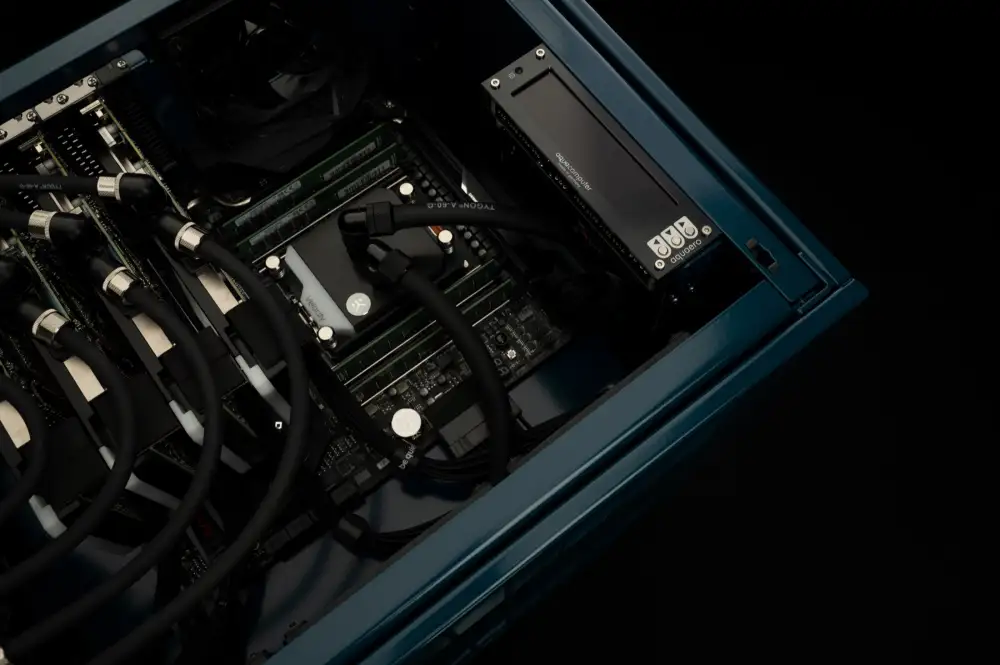
Uma plataforma de servidor com dois CPUs num único chassis projetado em CAD, arrefecida por um só circuito de refrigeração líquida.
Trabalho como fornecedor da NVIDIA em sistemas de IA, renderização e visualização. Os clientes da WS.COMPUTER estão em mais de 30 países.
Máquinas ao longo de sucessivas gerações de GPUs, cada uma especificada para a sua carga de trabalho.
A partir dos modelos que utiliza. O número de parâmetros, a quantização, o comprimento de contexto e o tamanho de lote determinam a VRAM e a largura de banda de memória necessárias. É a primeira questão da consulta.
Depende do consumo contínuo e do objetivo de ruído. Duas GPUs podem muitas vezes ser arrefecidas a ar. Quatro ou mais GPUs sob carga contínua precisam normalmente de um circuito de refrigeração líquida personalizado.
Sim. As máquinas são entregues em toda a UE e no resto do mundo, em embalagens de transporte feitas à medida. A colocação em funcionamento remota no seu ambiente faz parte de cada entrega.
Descreva os modelos, os dados e onde a máquina será utilizada.
Ou por e-mail info@gruency.com · Configurar na WS.COMPUTER