프로토타입, 2017년
하나의 섀시에 수랭 GPU 11개
CAD로 설계한 하나의 케이스에 듀얼 CPU 서버 플랫폼을 탑재하고 하나의 수랭 루프로 냉각했습니다.
GRUENCY / AI 워크스테이션
모델 학습과 로컬 LLM 추론은 장비를 몇 시간 또는 며칠 동안 최대 출력으로 가동합니다. GRUENCY는 이러한 연속 부하에 맞춰 GPU, 전원 공급, 냉각을 설계합니다. 모든 AI 워크스테이션은 납품 전 번인 테스트를 거칩니다.
실행하는 모델을 출발점으로 연산 성능, 메모리, PCIe 레인, 전력, 소음을 함께 정합니다.
모든 AI 워크스테이션은 개별 테스트 기록과 함께 바르샤바에서 출고됩니다. 기록에는 지속적인 최대 부하 번인, 모든 GPU의 열 프로파일, 합의된 목표 대비 소음 점검이 포함됩니다. 도착 후에는 Sebastian이 원격으로 고객 환경에 맞춰 설치 및 가동합니다. 속도도 측정합니다: GPU 및 메모리 성능, 언어 모델의 초당 토큰 수.
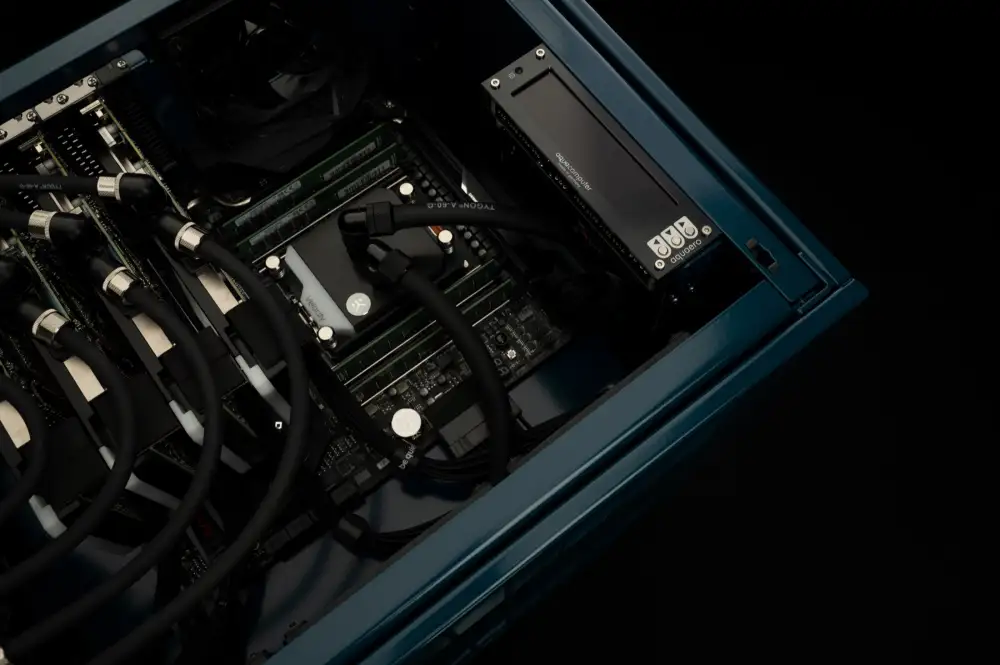
CAD로 설계한 하나의 케이스에 듀얼 CPU 서버 플랫폼을 탑재하고 하나의 수랭 루프로 냉각했습니다.
AI, 렌더링, 시각화 시스템 분야에서 NVIDIA에 공급업체로 참여한 작업. WS.COMPUTER의 고객은 30개국 이상에 있습니다.
여러 세대의 GPU에 걸쳐 제작한 장비로, 각각 해당 작업에 맞춰 사양을 정했습니다.
실행하는 모델을 기준으로 정합니다. 파라미터 수, 양자화, 컨텍스트 길이, 배치 크기에 따라 필요한 VRAM과 메모리 대역폭이 결정됩니다. 상담에서 가장 먼저 확인하는 사항입니다.
지속 전력 소비와 소음 목표에 따라 다릅니다. GPU 2개는 대개 공랭으로 충분합니다. 연속 부하에서 GPU 4개 이상이면 보통 맞춤형 수랭 루프가 필요합니다.
예. 장비는 맞춤 운송 포장으로 EU 전역과 전 세계에 배송됩니다. 고객 환경에 맞춘 원격 설치 및 가동이 모든 납품에 포함됩니다.