Prototipo, 2017
11 GPU raffreddate a liquido in un solo chassis
Una piattaforma server dual-CPU in un unico chassis progettato in CAD, raffreddata da un solo circuito a liquido.
GRUENCY / Workstation AI
L'addestramento di modelli e l'inferenza LLM locale mantengono una macchina a piena potenza per ore o giorni. GRUENCY dimensiona GPU, alimentazione e raffreddamento per questo carico continuo. Ogni workstation AI viene collaudata con burn-in prima della consegna.
Potenza di calcolo, memoria, linee PCIe, alimentazione e rumorosità vengono specificate insieme, a partire dai modelli che Lei utilizza.
Ogni workstation AI lascia Varsavia con il proprio rapporto di collaudo, che comprende un burn-in prolungato a pieno carico, un profilo termico di ogni GPU e una verifica della rumorosità rispetto all'obiettivo concordato. All'arrivo, Sebastian mette in servizio la macchina da remoto nel Suo ambiente.
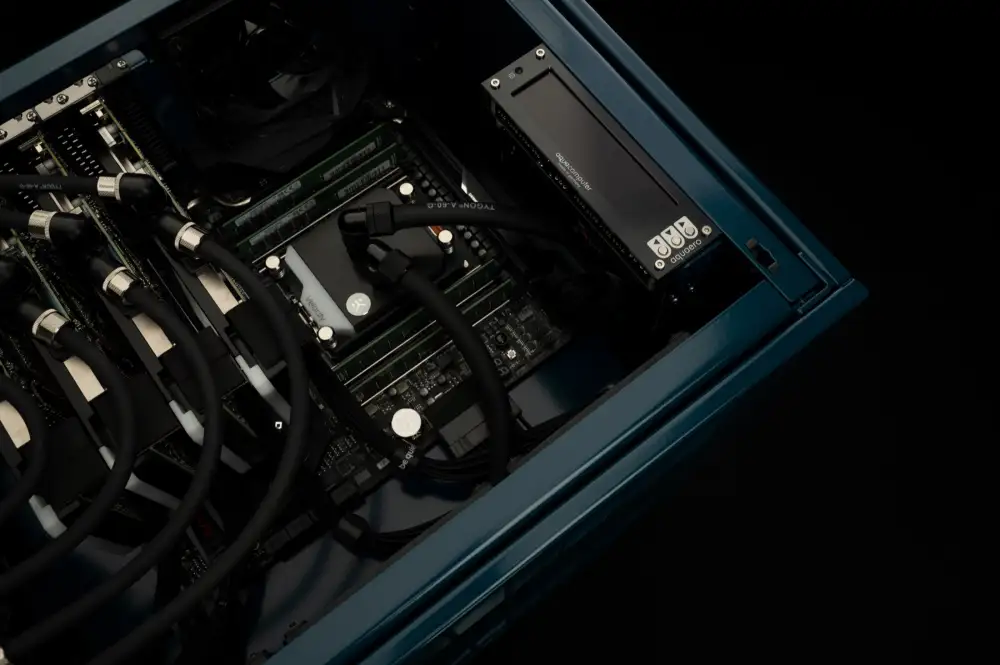
Una piattaforma server dual-CPU in un unico chassis progettato in CAD, raffreddata da un solo circuito a liquido.
Lavori come fornitore per NVIDIA su sistemi di AI, rendering e visualizzazione. I clienti di WS.COMPUTER hanno sede in oltre 30 paesi.
Macchine realizzate su generazioni successive di GPU, ciascuna specificata per il proprio carico di lavoro.
In base ai modelli che Lei utilizza. Numero di parametri, quantizzazione, lunghezza del contesto e dimensione del batch determinano la VRAM e la larghezza di banda della memoria necessarie. È la prima domanda della consulenza.
Dipende dall'assorbimento prolungato e dall'obiettivo di rumorosità. Due GPU si possono spesso raffreddare ad aria. Quattro o più GPU sotto carico continuo richiedono di solito un circuito a liquido su misura.
Sì. Le macchine vengono consegnate in tutta l'UE e nel resto del mondo, in imballaggi da trasporto su misura. La messa in servizio da remoto nel Suo ambiente fa parte di ogni consegna.
Descriva i modelli, i dati e il luogo in cui verrà utilizzata la macchina.
Oppure scriva a info@gruency.com · Configuri su WS.COMPUTER