Prototyp, 2017
11 wassergekühlte GPUs in einem Gehäuse
Eine Dual-CPU-Serverplattform in einem einzigen, per CAD konstruierten Gehäuse, gekühlt über einen Wasserkreislauf.
GRUENCY / KI-Workstations
Modelltraining und lokale LLM-Inferenz halten eine Maschine über Stunden oder Tage unter voller Leistung. GRUENCY dimensioniert GPUs, Stromversorgung und Kühlung für diese Dauerlast. Jede KI-Workstation durchläuft vor der Auslieferung einen Burn-in-Test.
Rechenleistung, Speicher, PCIe-Lanes, Stromversorgung und Geräuschpegel werden gemeinsam spezifiziert, ausgehend von den Modellen, die Sie einsetzen.
Jede KI-Workstation verlässt Warschau mit einem eigenen Prüfprotokoll. Es umfasst einen Burn-in-Test unter anhaltender Volllast, ein Temperaturprofil für jede GPU und eine Geräuschmessung im Abgleich mit dem vereinbarten Zielwert. Nach der Ankunft nimmt Sebastian die Maschine per Fernzugriff in Ihrer Umgebung in Betrieb.
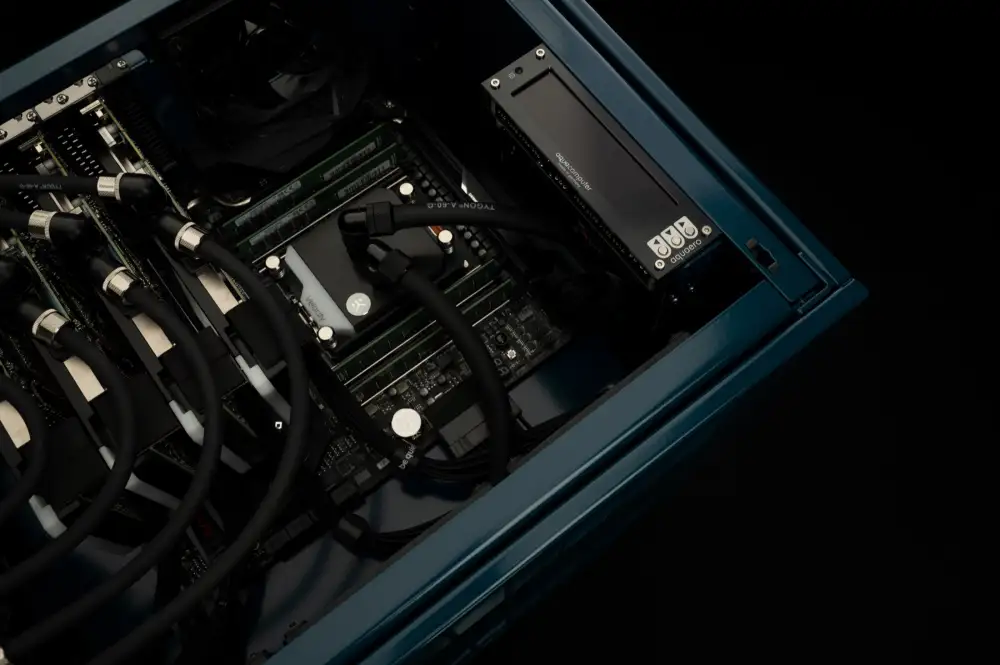
Eine Dual-CPU-Serverplattform in einem einzigen, per CAD konstruierten Gehäuse, gekühlt über einen Wasserkreislauf.
Tätigkeit als Lieferant für NVIDIA bei KI-, Rendering- und Visualisierungssystemen. Kunden von WS.COMPUTER sitzen in über 30 Ländern.
Maschinen über mehrere GPU-Generationen hinweg, jede für ihre Anwendung spezifiziert.
Ausgehend von den Modellen, die Sie einsetzen. Parameterzahl, Quantisierung, Kontextlänge und Batchgröße bestimmen den Bedarf an VRAM und Speicherbandbreite. Das ist die erste Frage im Beratungsgespräch.
Das hängt von der anhaltenden Leistungsaufnahme und dem Zielwert für den Geräuschpegel ab. Zwei GPUs lassen sich oft mit Luft kühlen. Vier oder mehr GPUs unter Dauerlast erfordern in der Regel einen individuellen Wasserkreislauf.
Ja. Die Maschinen werden in eigens angefertigter Transportverpackung in die gesamte EU und weltweit geliefert. Die Inbetriebnahme per Fernzugriff in Ihrer Umgebung ist Teil jeder Lieferung.
Beschreiben Sie die Modelle, die Daten und den Einsatzort der Maschine.
Oder per E-Mail an info@gruency.com · Konfiguration bei WS.COMPUTER