Прототип, 2017
11 GPU с водяным охлаждением в одном корпусе
Двухпроцессорная серверная платформа в одном корпусе, спроектированном в CAD, с одним водяным контуром.
GRUENCY / Станции для ИИ
Обучение моделей и локальный инференс LLM держат машину на полной мощности часами или сутками. GRUENCY подбирает GPU, питание и охлаждение под такую непрерывную нагрузку. Каждая станция для ИИ проходит стресс-тест перед поставкой.
Вычисления, память, линии PCIe, питание и шум определяются вместе, исходя из моделей, которые вы запускаете.
Каждая станция для ИИ уезжает из Варшавы с собственным протоколом испытаний. В него входят длительный стресс-тест под полной нагрузкой, тепловой профиль каждого GPU и проверка шума по согласованному значению. После доставки Sebastian удалённо вводит машину в эксплуатацию в вашей среде. Измеряется и скорость: производительность GPU и памяти, а также токены в секунду на языковых моделях.
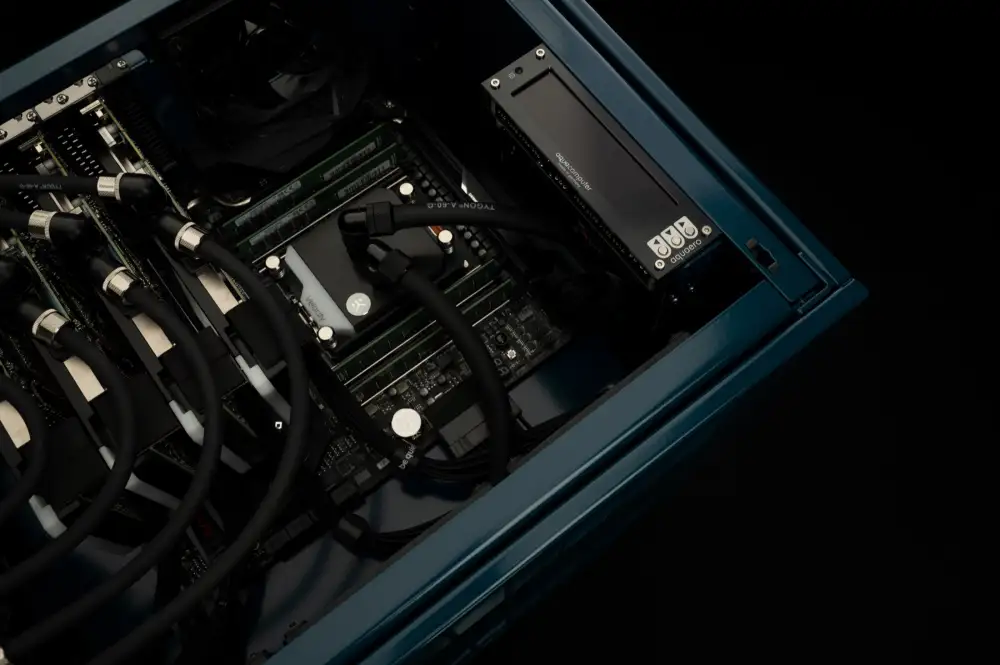
Двухпроцессорная серверная платформа в одном корпусе, спроектированном в CAD, с одним водяным контуром.
Работы для NVIDIA в области систем ИИ, рендеринга и визуализации. Клиенты WS.COMPUTER находятся более чем в 30 странах.
Машины на нескольких поколениях GPU, каждая под свою задачу.
Исходя из моделей, которые вы запускаете. Число параметров, квантизация, длина контекста и размер батча определяют необходимый объём VRAM и пропускную способность памяти. Это первый вопрос на консультации.
Зависит от длительного энергопотребления и целевого уровня шума. Две GPU часто можно охлаждать воздухом. Четыре и более GPU под постоянной нагрузкой обычно требуют заказного водяного контура.
Да. Машины поставляются по всему ЕС и миру в специальной транспортной упаковке. Удалённый ввод в эксплуатацию в вашей среде входит в каждую поставку.
Опишите модели, данные и место, где будет работать машина.
Или напишите на info@gruency.com · Сконфигурировать на WS.COMPUTER