プロトタイプ、2017年
1台の筐体に水冷GPU 11基
CAD設計の1台の筐体に収めたデュアルCPUサーバープラットフォームを、1系統の水冷ループで冷却。
GRUENCY / AIワークステーション
モデルの学習やローカルLLM推論では、マシンが数時間から数日にわたり全力で稼働し続けます。GRUENCY は、この連続負荷に合わせてGPU、電源供給、冷却の規模を決めます。各AIワークステーションは納品前にバーンインで試験します。
演算性能、メモリ、PCIeレーン、電源、騒音は、お使いのモデルを出発点としてまとめて仕様を決めます。
各AIワークステーションは、固有の試験記録とともにワルシャワから出荷されます。記録には、長時間の全負荷バーンイン、全GPUの熱プロファイル、合意した目標値に対する騒音確認が含まれます。到着後、Sebastian がお客様の環境でリモートにより立ち上げます。速度も測定します:GPUとメモリの性能、言語モデルの毎秒トークン数です。
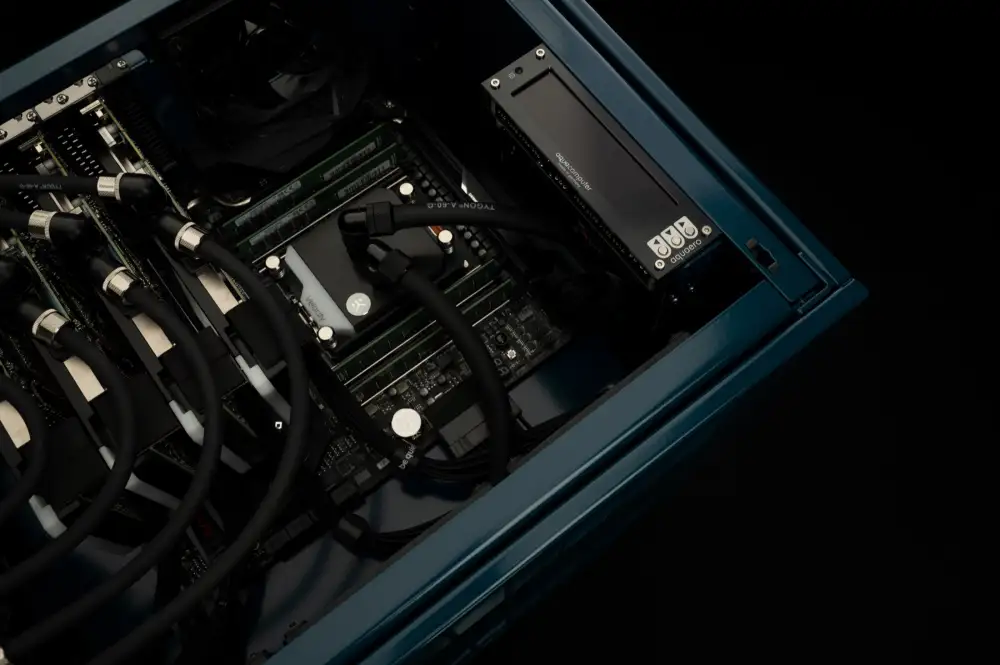
CAD設計の1台の筐体に収めたデュアルCPUサーバープラットフォームを、1系統の水冷ループで冷却。
NVIDIA 向けに、AI、レンダリング、可視化システムの業務を行いました。WS.COMPUTER の顧客は30か国以上に及びます。
歴代のGPU世代にわたるマシン。いずれも用途に合わせて仕様を決めています。
お使いのモデルから決めます。パラメータ数、量子化、コンテキスト長、バッチサイズによって、必要なVRAMとメモリ帯域が決まります。これが相談で最初に確認する点です。
持続消費電力と騒音の目標値によります。GPU 2基なら空冷で足りることが多いですが、連続負荷でGPU 4基以上となると、通常はカスタム水冷ループが必要です。
はい。マシンは専用の輸送用梱包でEU全域および世界各国に納品します。お客様の環境へのリモート立ち上げは、すべての納品に含まれます。