Prototyp, 2017
11 GPU chłodzonych cieczą w jednej obudowie
Dwuprocesorowa platforma serwerowa w jednej obudowie zaprojektowanej w CAD, chłodzona jednym obiegiem cieczy.
GRUENCY / Stacje robocze AI
Trenowanie modeli i lokalna inferencja LLM utrzymują maszynę na pełnej mocy przez wiele godzin lub dni. GRUENCY dobiera GPU, zasilanie i chłodzenie pod takie ciągłe obciążenie. Każda stacja robocza AI przechodzi przed dostawą test obciążeniowy (burn-in).
Moc obliczeniowa, pamięć, linie PCIe, zasilanie i hałas są określane łącznie, na podstawie uruchamianych modeli.
Każda stacja robocza AI opuszcza Warszawę z własnym protokołem testów. Obejmuje on długotrwały test pod pełnym obciążeniem (burn-in), profil termiczny każdego GPU i pomiar hałasu względem uzgodnionego poziomu. Po dostawie Sebastian zdalnie uruchamia maszynę w środowisku klienta.
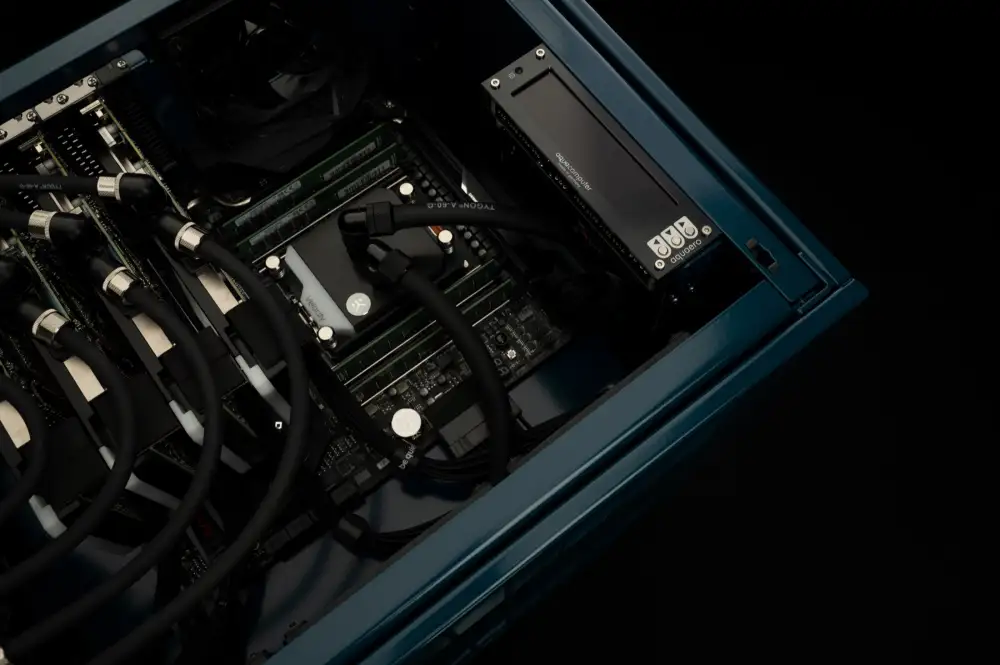
Dwuprocesorowa platforma serwerowa w jednej obudowie zaprojektowanej w CAD, chłodzona jednym obiegiem cieczy.
Realizacje dla NVIDIA w obszarze systemów AI, renderingu i wizualizacji. Klienci WS.COMPUTER pochodzą z ponad 30 krajów.
Maszyny oparte na kolejnych generacjach GPU, każda skonfigurowana pod konkretne zadania.
Na podstawie uruchamianych modeli. Liczba parametrów, kwantyzacja, długość kontekstu i rozmiar partii (batch size) określają potrzebną ilość VRAM i przepustowość pamięci. To pierwsze pytanie podczas konsultacji.
Zależy to od długotrwałego poboru mocy i docelowego poziomu hałasu. Dwa GPU często można chłodzić powietrzem. Cztery lub więcej GPU pod ciągłym obciążeniem zwykle wymagają indywidualnego układu chłodzenia cieczą.
Tak. Maszyny są dostarczane na terenie UE i na całym świecie w opakowaniach transportowych wykonanych na wymiar. Każda dostawa obejmuje zdalne uruchomienie w środowisku klienta.
Proszę opisać modele, dane i miejsce, w którym maszyna będzie pracować.
Można też napisać na adres info@gruency.com · Konfigurator: WS.COMPUTER