Prototipo, 2017
11 GPU refrigeradas por agua en un solo chasis
Una plataforma de servidor de doble CPU en una única caja diseñada en CAD, refrigerada por un solo circuito de agua.
GRUENCY / Estaciones de trabajo para IA
El entrenamiento de modelos y la inferencia local de LLM mantienen una máquina a plena potencia durante horas o días. GRUENCY dimensiona las GPU, la alimentación y la refrigeración para esa carga continua. Cada estación de trabajo para IA se prueba con burn-in antes de la entrega.
El cálculo, la memoria, las líneas PCIe, la alimentación y el ruido se especifican de forma conjunta, a partir de los modelos que usted ejecuta.
Cada estación de trabajo para IA sale de Varsovia con su propio registro de pruebas. Este incluye una prueba de burn-in a plena carga sostenida, un perfil térmico de cada GPU y un control de ruido frente al objetivo acordado. A la llegada, Sebastian pone en marcha la máquina a distancia en su entorno.
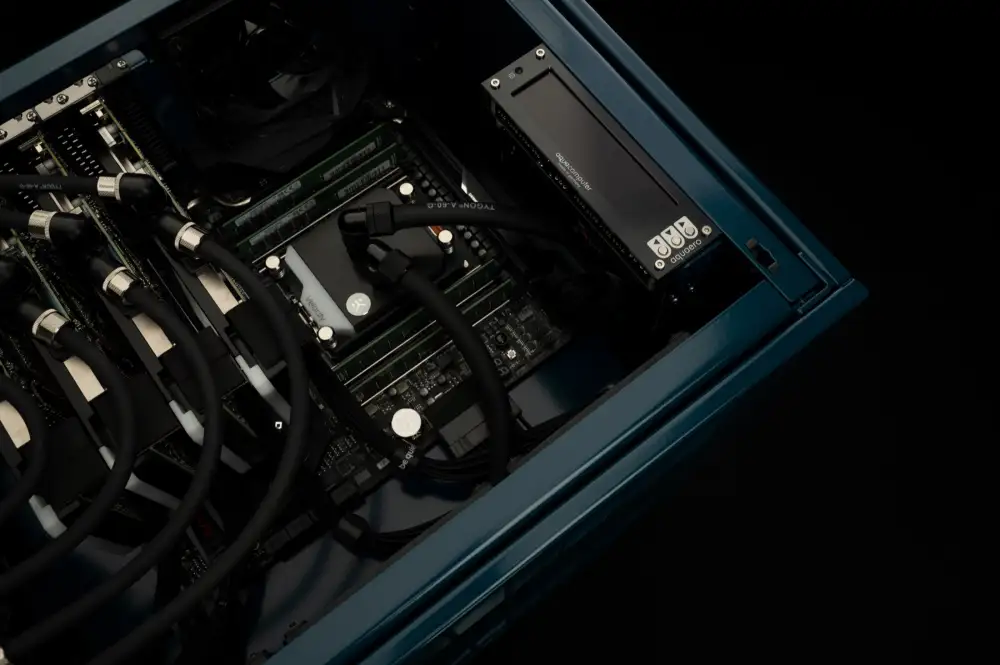
Una plataforma de servidor de doble CPU en una única caja diseñada en CAD, refrigerada por un solo circuito de agua.
Trabajos para NVIDIA en sistemas de IA, renderizado y visualización. Los clientes de WS.COMPUTER se encuentran en más de 30 países.
Máquinas de sucesivas generaciones de GPU, cada una especificada para su carga de trabajo.
A partir de los modelos que usted ejecuta. El número de parámetros, la cuantización, la longitud de contexto y el tamaño de lote determinan la VRAM y el ancho de banda de memoria necesarios. Es la primera pregunta de la consulta.
Depende del consumo sostenido y del objetivo de ruido. A menudo, dos GPU pueden refrigerarse por aire. Cuatro o más GPU bajo carga continua suelen necesitar un circuito de agua a medida.
Sí. Las máquinas se entregan en toda la UE y en el resto del mundo en un embalaje de transporte a medida. La puesta en marcha a distancia en su entorno forma parte de cada entrega.
Describa los modelos, los datos y dónde se utilizará la máquina.
O escriba a info@gruency.com · Configure en WS.COMPUTER