प्रोटोटाइप, 2017
एक चेसिस में 11 वॉटर-कूल्ड GPU
एक ही CAD-डिज़ाइन किए गए केस में डुअल-CPU सर्वर प्लेटफ़ॉर्म, एक वॉटर लूप से कूल किया गया।
GRUENCY / AI वर्कस्टेशन
मॉडल ट्रेनिंग और लोकल LLM इन्फ़रेंस मशीन को घंटों या दिनों तक पूरी पावर पर रखते हैं। GRUENCY इसी लगातार लोड के अनुसार GPU, पावर डिलीवरी और कूलिंग तय करता है। हर AI वर्कस्टेशन डिलीवरी से पहले बर्न-इन में टेस्ट किया जाता है।
कंप्यूट, मेमोरी, PCIe लेन, पावर और नॉइज़ एक साथ स्पेसिफ़ाई किए जाते हैं, आपके द्वारा चलाए जाने वाले मॉडलों से शुरू करके।
हर AI वर्कस्टेशन अपने टेस्ट रिकॉर्ड के साथ वारसॉ से रवाना होता है। इसमें लगातार फ़ुल-लोड बर्न-इन, हर GPU की थर्मल प्रोफ़ाइल और तय लक्ष्य के मुकाबले नॉइज़ जाँच शामिल है। पहुँचने पर Sebastian मशीन को रिमोट रूप से आपके एनवायरनमेंट में कमीशन करते हैं। स्पीड भी मापी जाती है: GPU और मेमोरी परफ़ॉर्मेंस, और लैंग्वेज मॉडल पर टोकन प्रति सेकंड।
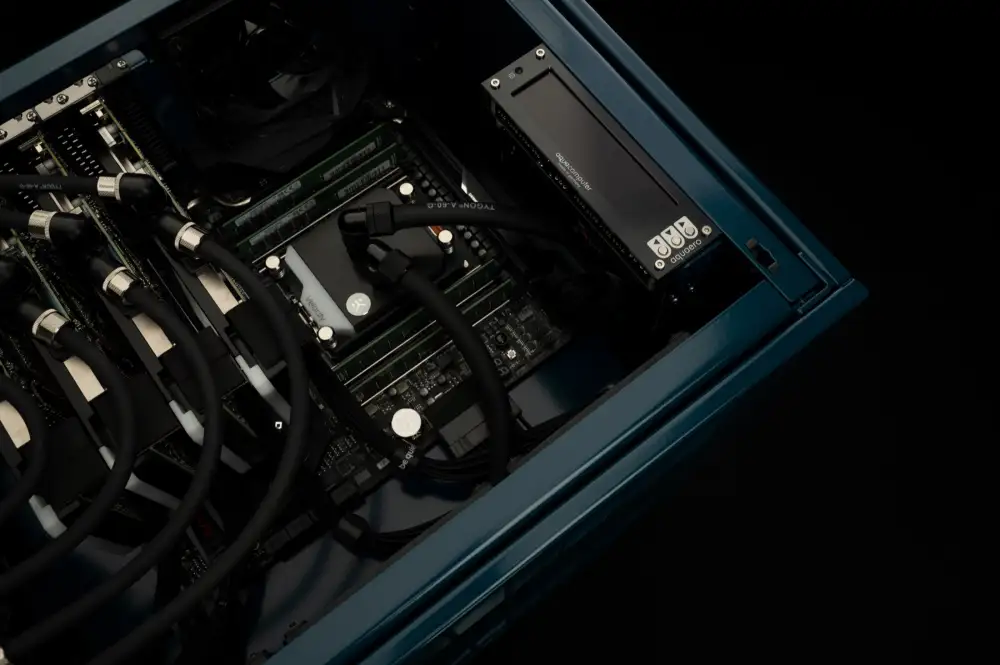
एक ही CAD-डिज़ाइन किए गए केस में डुअल-CPU सर्वर प्लेटफ़ॉर्म, एक वॉटर लूप से कूल किया गया।
AI, रेंडरिंग और विज़ुअलाइज़ेशन सिस्टम्स पर NVIDIA के लिए वेंडर कार्य। WS.COMPUTER के क्लाइंट्स 30 से अधिक देशों में हैं।
GPU की लगातार पीढ़ियों में बनी मशीनें, हर एक अपने वर्कलोड के अनुसार स्पेसिफ़ाई की गई।
आपके द्वारा चलाए जाने वाले मॉडलों से। पैरामीटर संख्या, क्वांटाइज़ेशन, कॉन्टेक्स्ट लेंथ और बैच साइज़ आवश्यक VRAM और मेमोरी बैंडविड्थ तय करते हैं। कंसल्टेशन में यही पहला प्रश्न होता है।
यह लगातार पावर ड्रॉ और नॉइज़ लक्ष्य पर निर्भर करता है। दो GPU को अक्सर एयर-कूल किया जा सकता है। लगातार लोड में चार या अधिक GPU के लिए आमतौर पर कस्टम वॉटर लूप चाहिए।
हाँ। मशीनें कस्टम ट्रांसपोर्ट पैकेजिंग में पूरे EU और विश्वभर में डिलीवर की जाती हैं। आपके एनवायरनमेंट में रिमोट कमीशनिंग हर डिलीवरी का हिस्सा है।
मॉडल, डेटा और मशीन कहाँ उपयोग होगी, इसका विवरण दें।
या ईमेल करें info@gruency.com · WS.COMPUTER पर कॉन्फ़िगर करें